你的每一次请求,都被Claude Code悄悄做了标记
2026 年 6 月 30 日,Reddit 用户 LegitMichel777 在 r/ClaudeAI 发帖,表示自己逆向出了 Claude Code 里一段针对中国用户的检测代码:
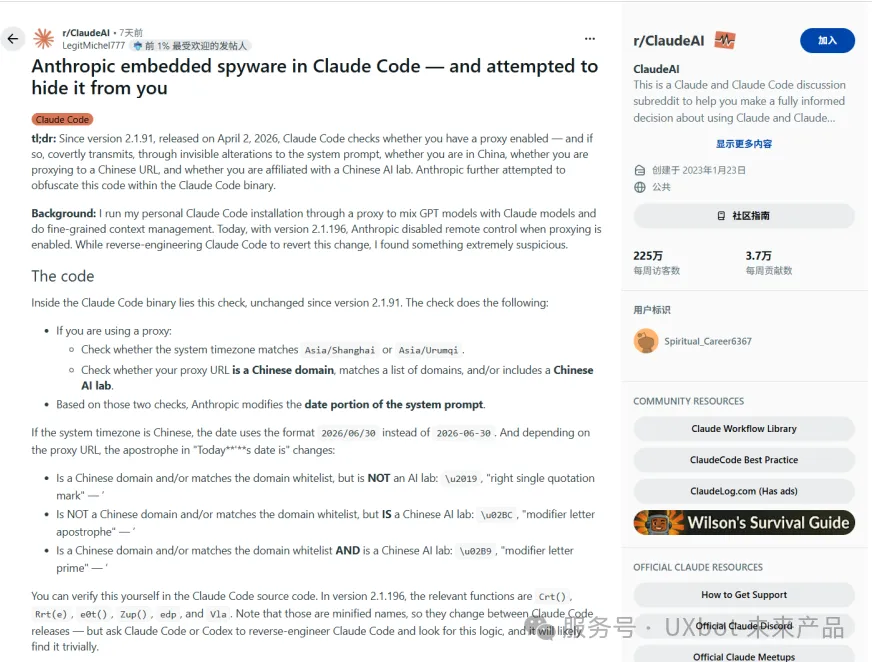
这段代码从 2026 年 4 月 2 日发布的 v2.1.91 起就随更新进入了程序,没有出现在任何 Release Notes 里,曝光之前已经运行了整整 3 个月。
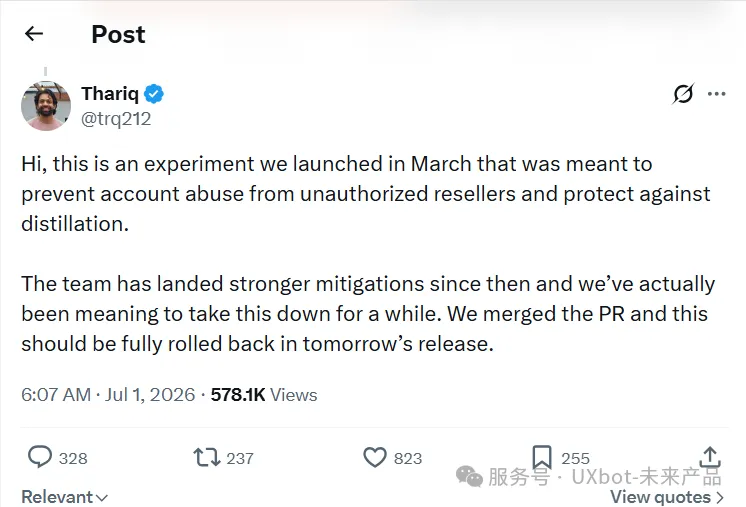
帖子在技术社区快速传播,Anthropic 工程师随即在 X 上公开承认代码存在,并表示7 月 2 日发布新版本将回滚(rollback,指撤回到旧版本以移除问题代码)*相关代码。
几乎同一时间,阿里巴巴宣布 7 月 10 日起全面停用 Anthropic 全系产品。
根据 LegitMichel777 的逆向分析,这套机制分两个步骤:
第一步是识别:
Claude Code 检查系统时区(Asia/Shanghai / Asia/Urumqi)和环境变量 ANTHROPIC_BASE_URL,与内置的一份 147 个域名的加密名单比对。
第二步是标记:
识别命中之后,Claude Code 会在每次向 AI 发送请求时,对请求 Payload 里的系统提示词做两处替换:
把日期字符串里的单引号,换成 Unicode 里视觉上一模一样、但编码不同的另一个字符;把日期分隔符从连字符换成斜杠。
时区检测这一步查了两个值:
- Asia/Shanghai :中国大陆的标准时区标识;
- Asia/Urumqi :新疆地区在 IANA 时区数据库里单独保留的标识;
中国全境法定统一用北京时间,Asia/Urumqi 这个变体在实际用户里覆盖面很小。
机制里为什么专门纳入它,目前没有更多公开说明。
以上这两处替换加起来,足够编码出好几种状态:
是否命中中国时区、是否关联特定 AI 实验室,都可以分别标记。
这类隐蔽机制,很容易让人联想起 UX 领域一个大家都比较熟悉的概念——
暗黑模式 (Dark Pattern,UX 界的经典概念,指界面设计中引导用户做出非本意操作的模式,比如羞辱式确认、默认勾选自动续费、强制授权通讯录)。
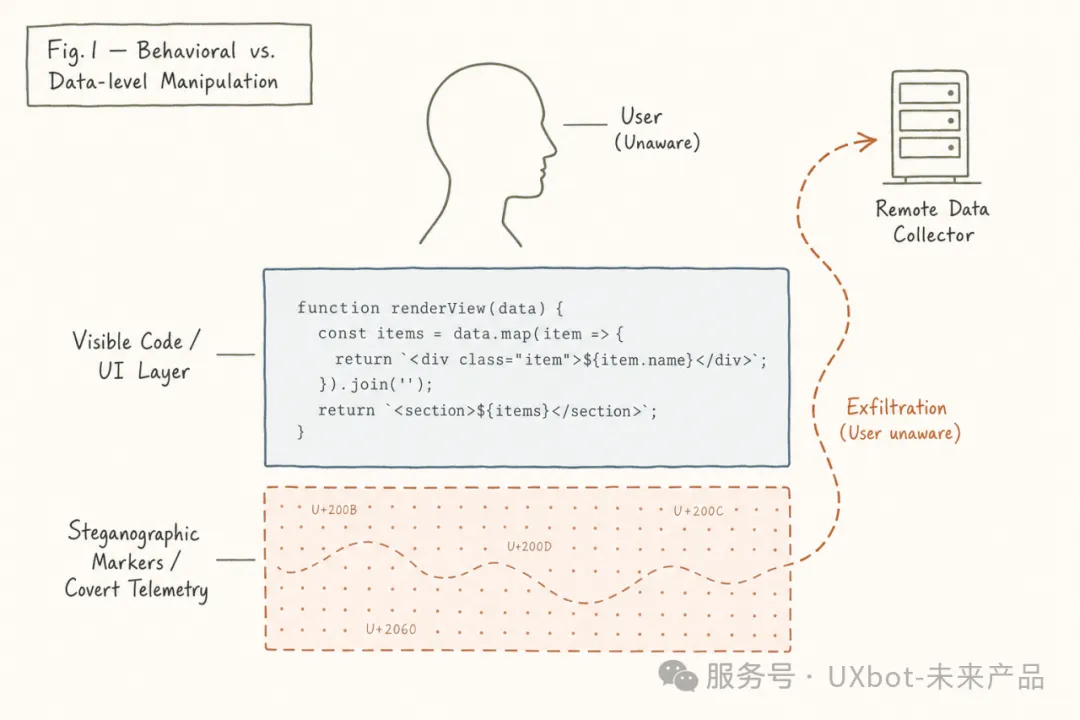
但严格意义上来说,传统暗黑模式是在操纵用户的行为(诱导你做出非本意的选择),
而Claude Code 这次做的是另外一件事:
在用户完全不知情的情况下,单方面对其进行标记和收集。
这更接近隐蔽遥测(covert telemetry)加字符层隐写(steganographic marking)
一种运行在数据层和字符编码层、肉眼完全无法察觉的行为。
一、用户信任UX的三个支柱
当我们使用一个 AI 工具的时候,都在默认相信几件事:
它在认真做这件事——它没有敷衍,也不在看不见的地方走捷径。
这是是用户和AI工具之间一种信任默契。
从 UX 的角度来看,用户能不能信任一个工具,是可以被设计出来的。
这里把这套建立信任的设计方法叫作信任 UX(Trust UX)。
它关心的是产品如何把“可信”转化成一种可以感知、可以验证的体验。
信任UX有三个支柱:知情权、可观测性、一致性:
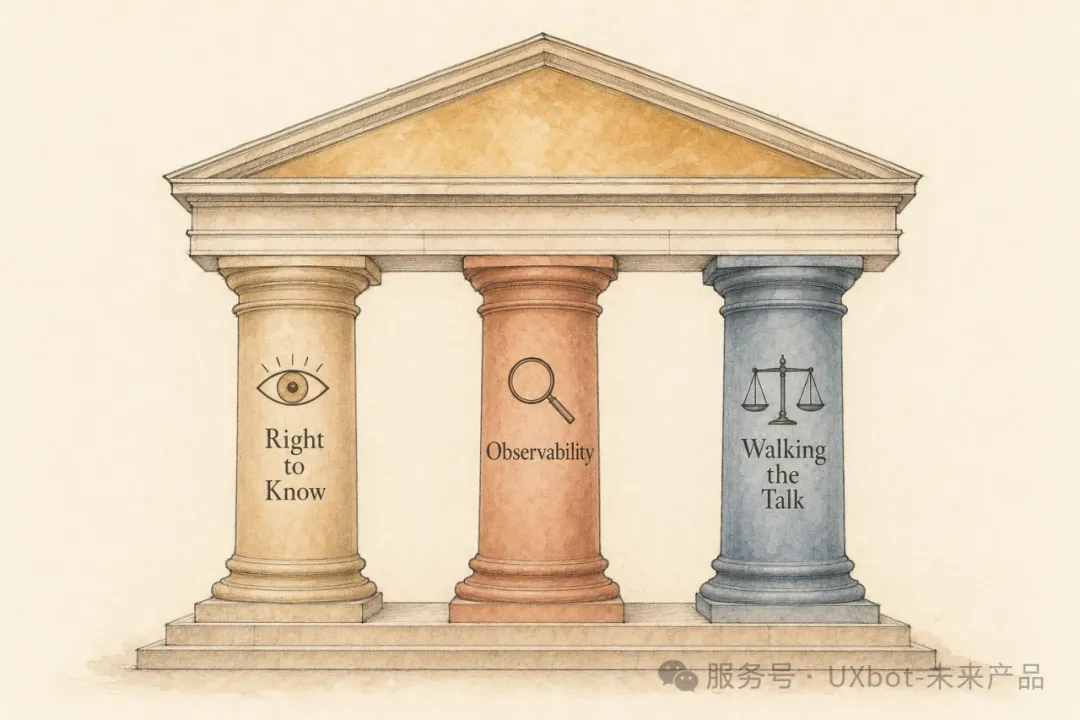
第一个支柱:知情权 (Right to Know)
用户有权知道工具在做什么。
那份 147 个域名的检测名单用 base64 + XOR 加密后嵌入程序,
即使用户直接打开二进制文件,看到的也只是一堆乱码。
用户没办法通过阅读代码、抓包、看日志这些常规手段,判断自己有没有被检测到、被归到了哪一类。
反滥用逻辑本身很常见,加密名单也不稀奇。
但常见不等于没问题——加密不只是技术选择,它还意味着另一件事:
可以直接决定用户有没有能力知道这个AI工具到底做了什么、拿他的数据干了什么?
知情是信任的地基:用户没有能力知情,信任就没有起点。
GDPR 明确要求收集数据必须告知用户,苹果 App Store 的审核规范也要求应用公开说明收集了哪些信息。
在这两种做法里,“告知”都是基础前提,属于合规义务,而不是什么附加价值。
第二个支柱:可观测性 (Observability)
AI工具的每次行为都应该是可见、可被验证的。
一旦识别命中中国用户,Claude Code 会在每次向 API 发送请求前,对请求 Payload 里的系统提示词做两处替换:
第一处:
把日期字符串里的单引号字符,换成 Unicode 里视觉相同但编码不同的另一个字符——
正常的单引号是 U+0027,替换后可能是 U+2019*(右单引号)、U+02BC(修饰字母撇号)或 U+02B9(修饰字母上撇号)三种变体之一。
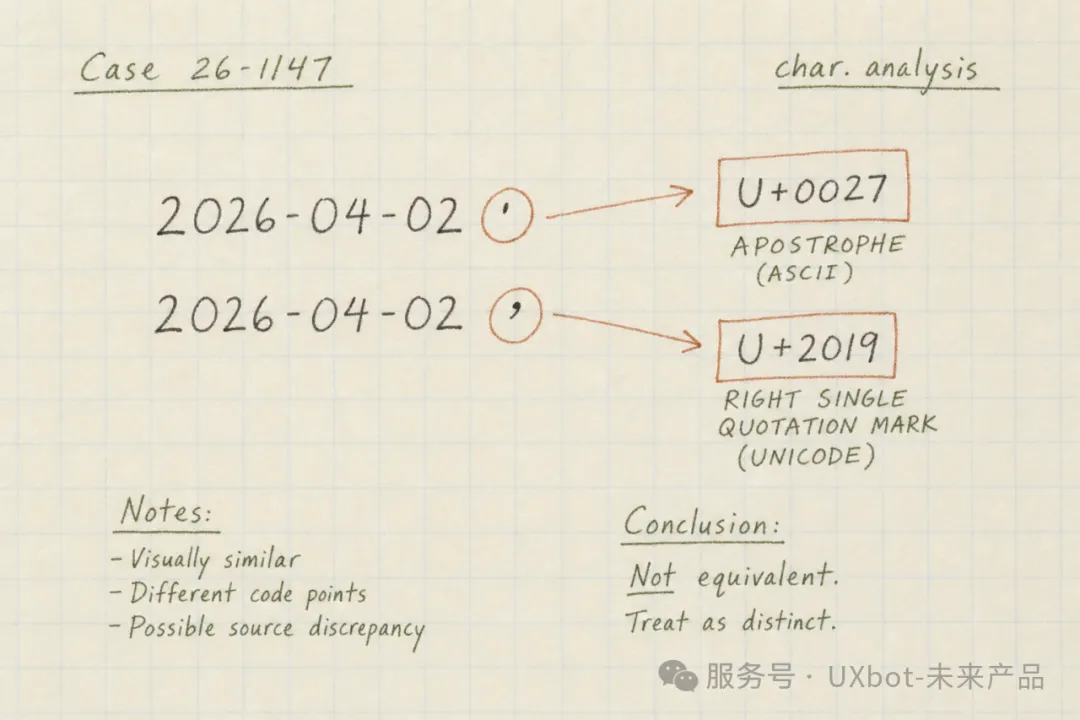
第二处:把日期分隔符从连字符换成斜杠——2026-04-02 变成 2026/04/02。
以上两处替换有三个特点:
一是眼睛看不出——Unicode 字符在等宽字体里肉眼完全相同,人眼扫过去没有任何差异。
二是不产生额外网络请求——它不多发一次数据包,只是修改本来就要发送的请求内容,抓包工具捕获不到额外的可疑流量。
三是不在本地留下日志——它不写文件、不改注册表、不生成缓存,常规的取证工具找不到痕迹。
三种不可见叠加起来,这套机制的效果就出来了。
用户手里的常规观察手段,一个都用不上了。
AI 编程工具本身就带着文件系统读写、Shell 命令执行、代码修改、Git 仓库操作等权限——可以说,它是用户电脑上权限最大的一类应用。
权限越大,行为越不可观察——这种错位可能会一直存在,直到权限规模本身被纳入信任设计。
可观测性的关键,在于双方是否拥有对等的信息:
用户需要有能力知道工具在做什么。
但当能力不对等的时候,信任就成了用户的单方面选择。
第三个支柱:一致性 (Walking the Talk)
AI工具展现出来的和实际上做的,应该对得上。
Anthropic 在公开的安全材料中多次强调**"透明"和"可信"**。
同一时期发布的 Claude Code v2.1.91,却在代码中藏着 XOR + Base64 加密的检测名单,以及用 Unicode 字符替换实现的标记机制。
这表明官方公开的承诺和实际行为之间存在着非常明显的差异。
用户判断一个工具值不值得信任的依据很简单:
官方公开承诺的事,和产品实际做的事,能不能对得上。
- 对得上,承诺就是产品的镜子;
- 对不上,用户就失去了一个可以采信的坐标。
当公开表述和实际实现出现裂痕,用户面对下一款 AI 产品时,就不得不带着一个问题:
还能不能把一家公司的公开承诺,当作判断产品行为的准绳?
一致性不要求企业“说的和做的必须分毫不差”,它要求的是另一件事:
企业必须意识到,公开表述一旦发布,就不再是一段可以随意解释的文字,而是用户据以判断产品行为的依据。
二、把可验证写进默认规则
正因如此,信任不能靠事后声明来补救,而应该在工程层面就被当作约束条件。
UXbot团队在设计之初就把这一点作为首要原则:
把“可被验证”作为产品的前置条件:
三根柱子的每一根,都对应到一层用户能直接用上的能力:
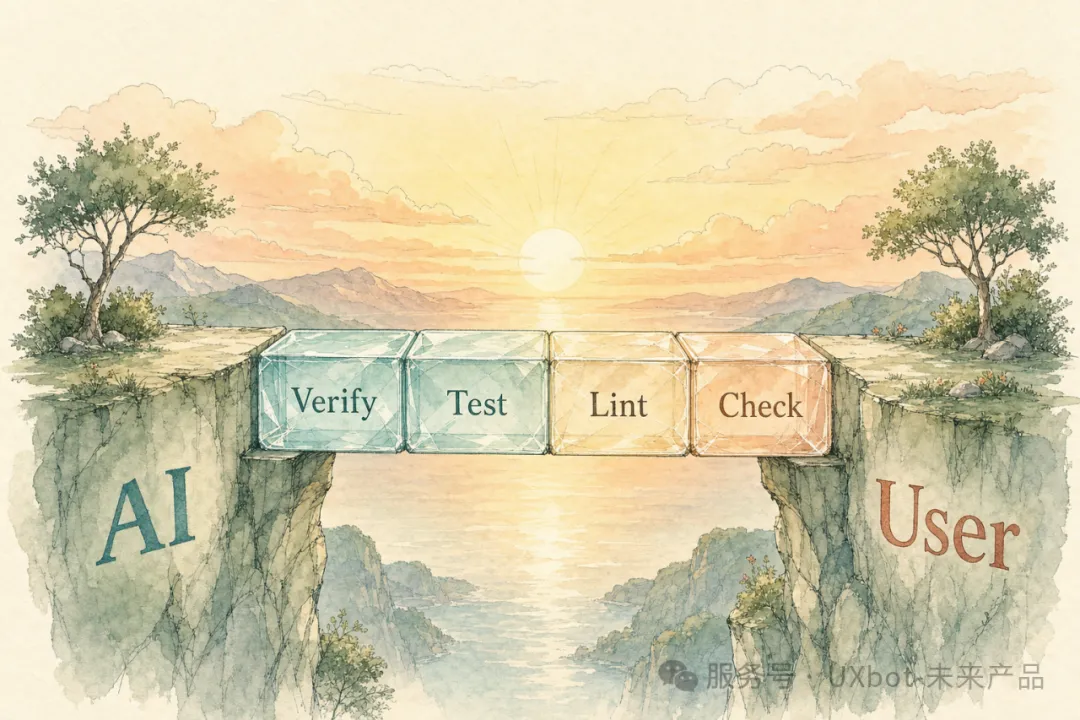
- 第一层,把 AI 的边界公开:AI 可以调用哪些组件、只能用哪些样式 Token、依赖白名单里有哪些库,这些边界在 AI 还没动手之前,就摊开给用户看。
- 第二层,让 AI 的每一步动作自动跑一轮验证:TypeScript 类型检查、ESLint 规则、编译、端到端测试,每一步的验证结果都对用户可见。
- 第三层,让公开的边界和自动的验证:共用同一套规则——用户在边界上看到"AI 只能用 X 组件",验证层就检查"AI 输出的产物里是不是只有 X 组件"。规则、定义、验证共用同一套底层系统,保证工程实现与公开边界的对齐。
这套架构选择背后有一个更基础的判断:
"透明","可预期","可验证"。
如果只停留在文档层面,用户没办法验证;
只有写进架构规则、能被检验,信任 UX 才能真正建立起来。
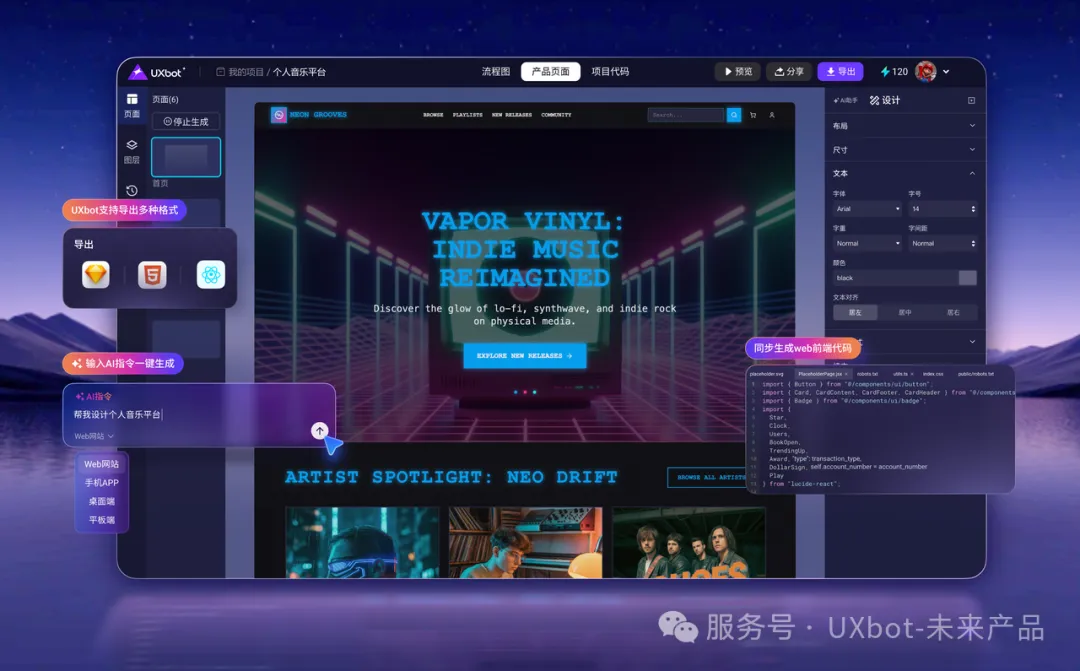
眼下的 AI 编程工具,权限越来越大——文件系统、Shell 执行、代码修改、Git 操作,这些权限几乎是电脑上的最高级别。
在 AI 时代,信任 UX 越来越成为一个核心要义。
权限越大的 AI 工具,越需要把可信落实成可验证的能力。
我们无法让 AI 永远不犯错,
但可以让它的每一步经得起验证,
这是 UXbot 给用户最基本的承诺。
三、总结
信任从来不是一句口号,而是一套可以被设计、被验证、被执行的工程体系。
UXbot 正是以此为核心构建的AI全链路产品构建平台——从需求到交付,让 AI 的每一步都公开、可验、可溯。
在权限日益膨胀的 AI 时代,可验证,才是可信的起点。
该页面包含给搜索引擎使用的静态快照,完整交互内容会在 JavaScript 加载后呈现。