从Prompt Engineering到Loop Engineering,产品构建范式是否在被重新定义?
最近 AI 圈又冒出一个新词:Loop Engineering.
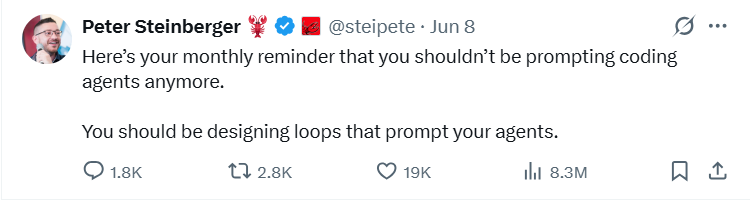
6月7号,OpenClaw 创始人 Peter Steinberger 在推特上发了一条内容:
“你不应该再给编程 Agent 写 Prompt 了——你应该设计用来驱动 Agent 的循环。”
这条内容的阅读量直接冲到了几百万:
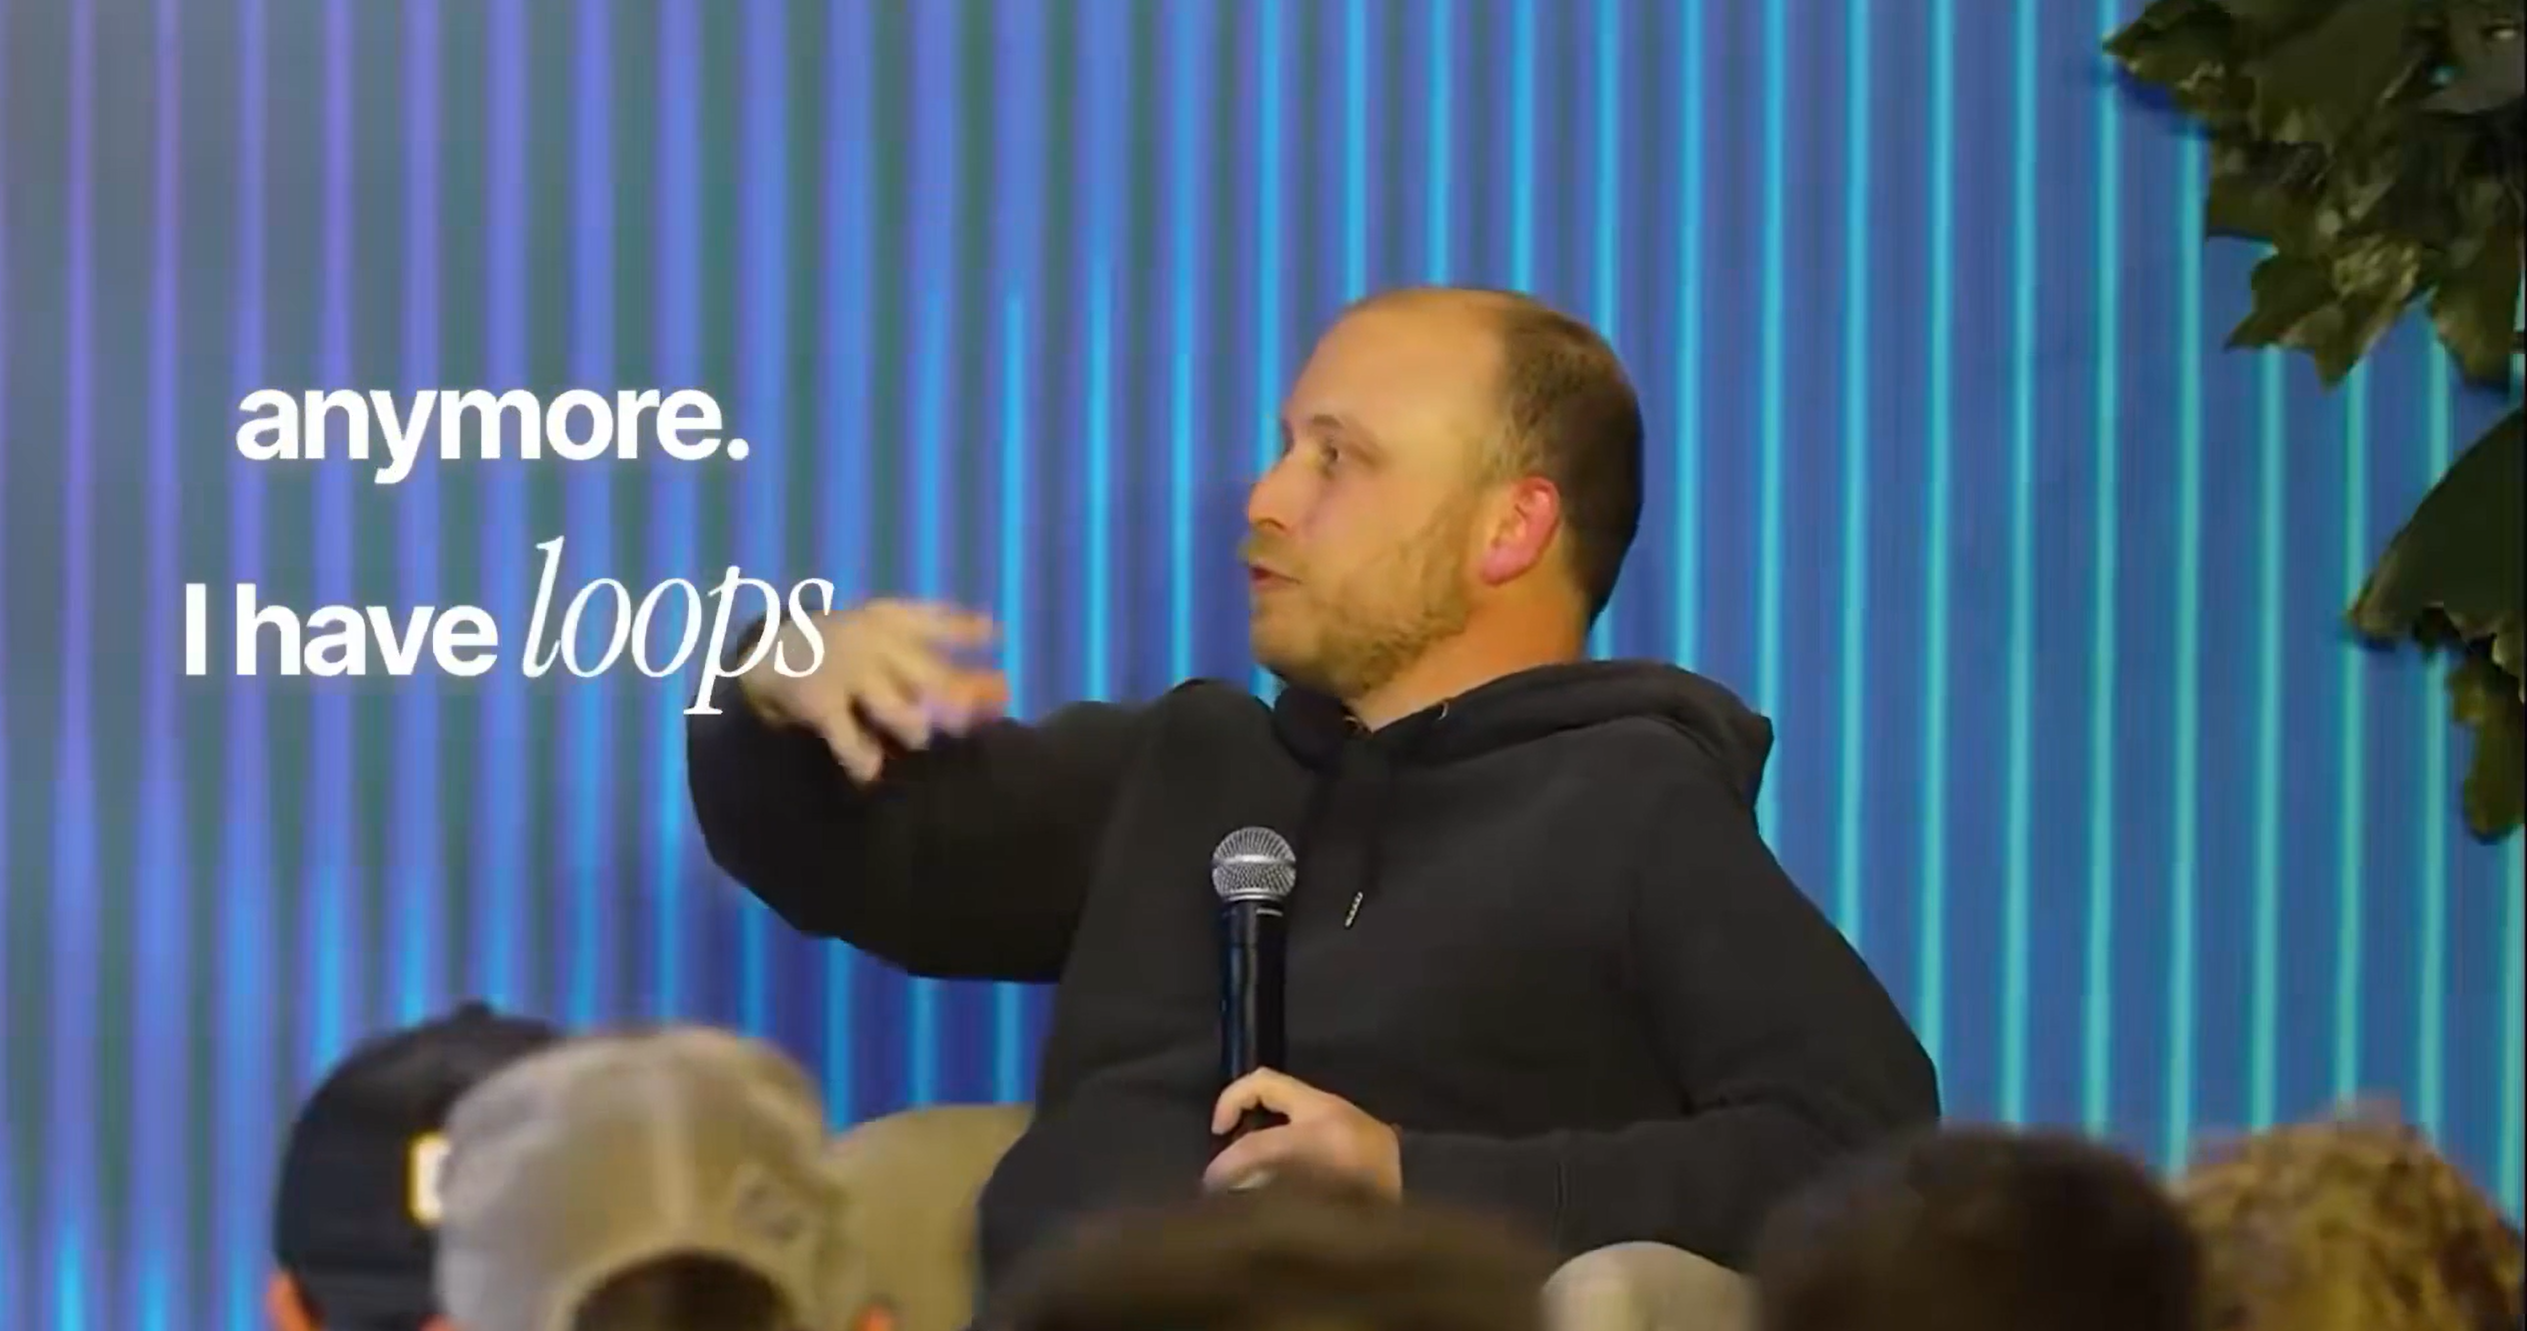
差不多的时间,Anthropic 旗下 Claude Code 的创始人 Boris Cherny 在一场开发者活动上讲了几乎一样的话:
"我已经不手动给 Claude 写 Prompt 了,我的工作变成了写 Loop。"
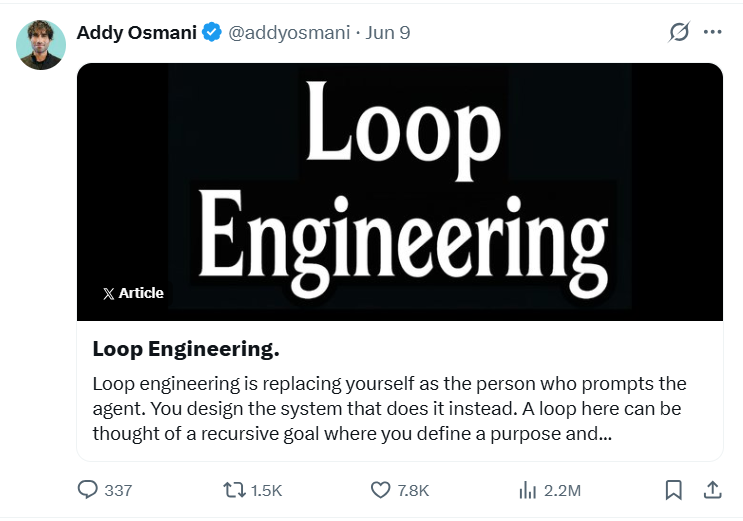
紧接着,Google 工程师 Addy Osmani 发了一篇长文,把Loop Engineering这个概念正式梳理了出来。
继PromptEngineering;ContextEngineering;HarnessEngineering 之后,
第四个 Engineering——Loop Engineering,就此诞生。
围绕它的讨论越来越热——Loop 是不是 Agent 的下一站?是不是所有团队都该换上 Loop 思维?
但当我们真正坐下来思考”AI 产品到底该怎么造"这件事时,面临的是不一样的思考角度。
至少在产品构建这件事上:
Loop,不见得是最重要的方法论。
一、四个 Engineering,四次跃迁
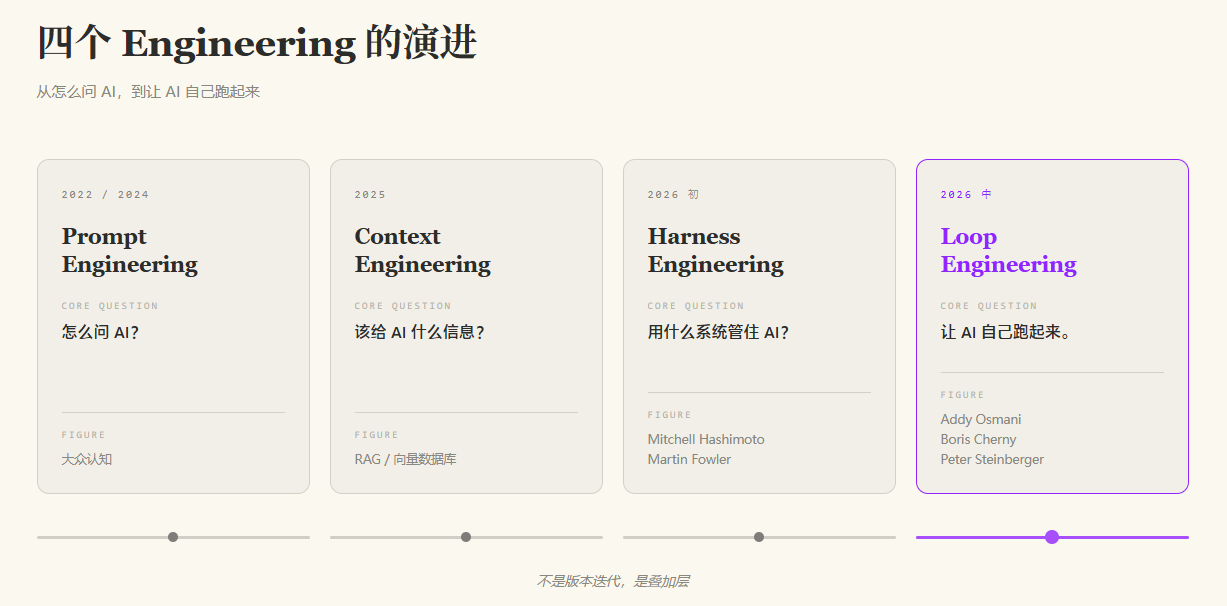
要弄懂 Loop Engineering 到底是什么?要从四个Engineering的演进路线中去理解:
1.Prompt Engineering:
Prompt作为第一代Engineering,其核心命题是:怎么问 AI? ——怎么写指令、怎么给示例、怎么调输出格式。
2.Context Engineering:
光会问还不够,得给足够的背景信息——RAG、向量数据库、上下文压缩、Token 预算。
命题变成:该给 AI 什么信息,它才答得准?
3.Harness Engineering:
Agent = 模型 + Harness
Harness 是马具、是缰绳,是套在模型外面的一整套约束系统。
ThoughtWorks 的 Martin Fowler 进一步把它拆成两半:
Guides(前馈/预防) 和 Sensors(反馈/检测)
前者画好跑道,告诉 AI 哪里能去、哪里不能去;
后者负责检查,看 AI 跑出来的东西到底对不对。
命题变成:该搭一套什么样的系统,把 AI 管住?
4.Loop Engineering:
这一代要做的事是再往前一步——让 AI 自己跑起来。
按 Addy Osmani 的拆解,
一个完整的 Loop 由五个不同组件 + 一层记忆组成,可以类比为:五块积木+一层记忆:
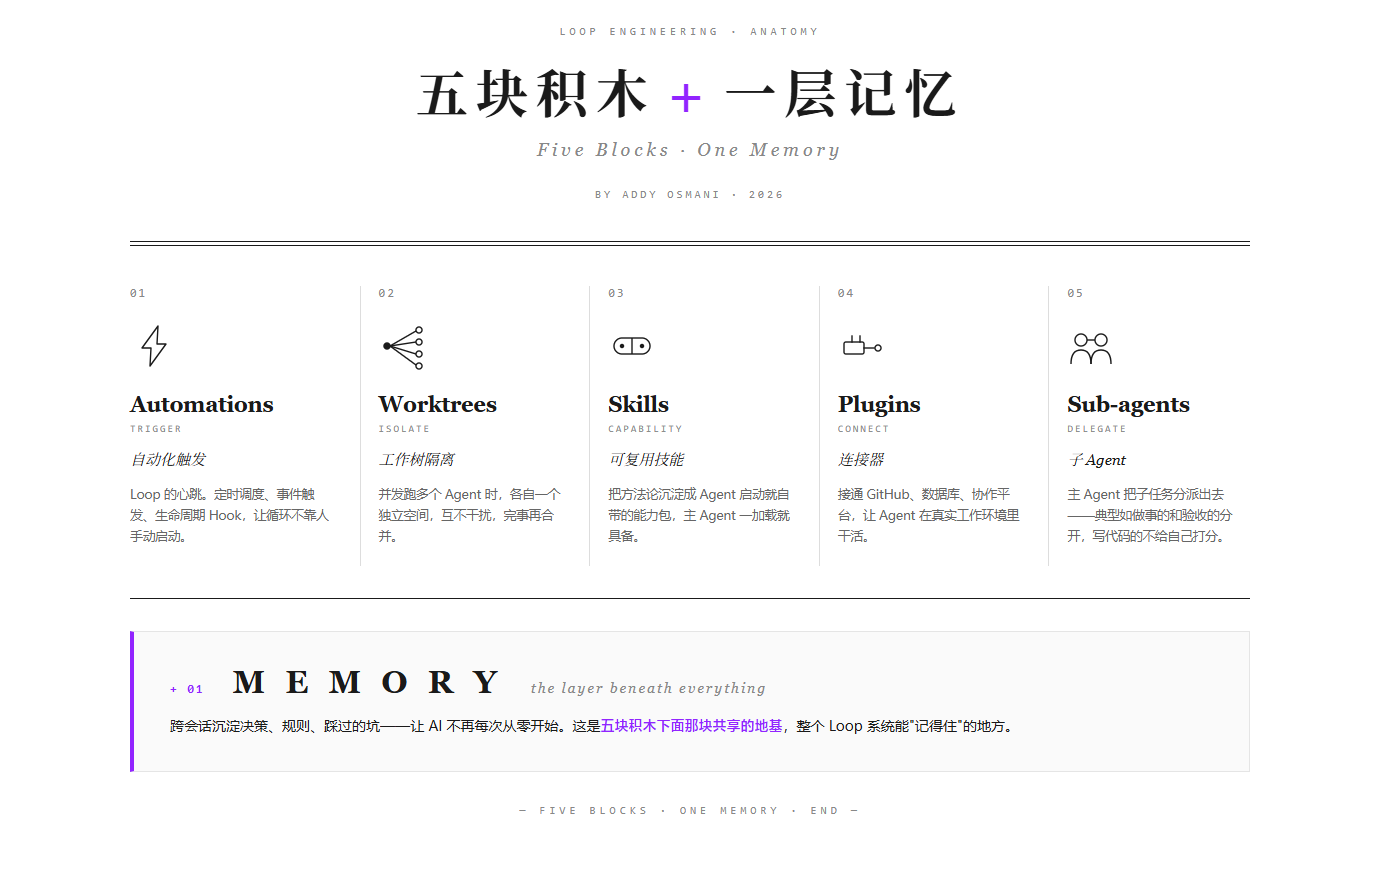
- Automations(自动化触发):定时调度、事件触发、生命周期 Hook,让循环不靠人手动启动。
- Worktrees(工作树隔离):并发跑多个 Agent 时,各自一个独立空间,互不干扰,完事再合并。
- Skills(可复用技能):把方法论沉淀成 Agent 启动就自带的能力包。
- Plugins / Connectors(连接器):接通 GitHub、数据库、协作平台,让 Agent 在真实工作环境里干活。
- Sub-agents(子 Agent):让主 Agent 把子任务分派给独立的 Agent 处理——典型用法是做事的和验收的分开,写代码的 Agent 不给自己打分。
- 外加一层记忆(Memory):跨会话沉淀决策、规则、踩过的坑——让 AI 不再每次从零开始。
把这六件事拼起来,就是一个能自己跑的 Loop。
命题至此变成——该搭一个怎样的系统,让 AI 自主往前跑?
二、Loop 和 Harness 分别适合什么场景
这四层engineering不是版本替代,是叠加。
Prompt 和 Context 早已是任何 Agent 系统都要做好的基本功——
它们解决的是"怎么把信息准确地给 AI"。
这一层今天已经成为共识,不再是分歧的所在。
真正引发讨论的,是这两层——Harness 和 Loop。
它们代表了两种工程直觉:
一种偏约束,一种偏自主。
- Harness 的直觉:先给 AI 划好边界,让它只能在受控范围里跑。
- Loop 的直觉:定好目标,让 AI 自己一轮一轮跑下去。
那该用哪一个?
这件事不需要在哲学层面争——只在场景层面看。
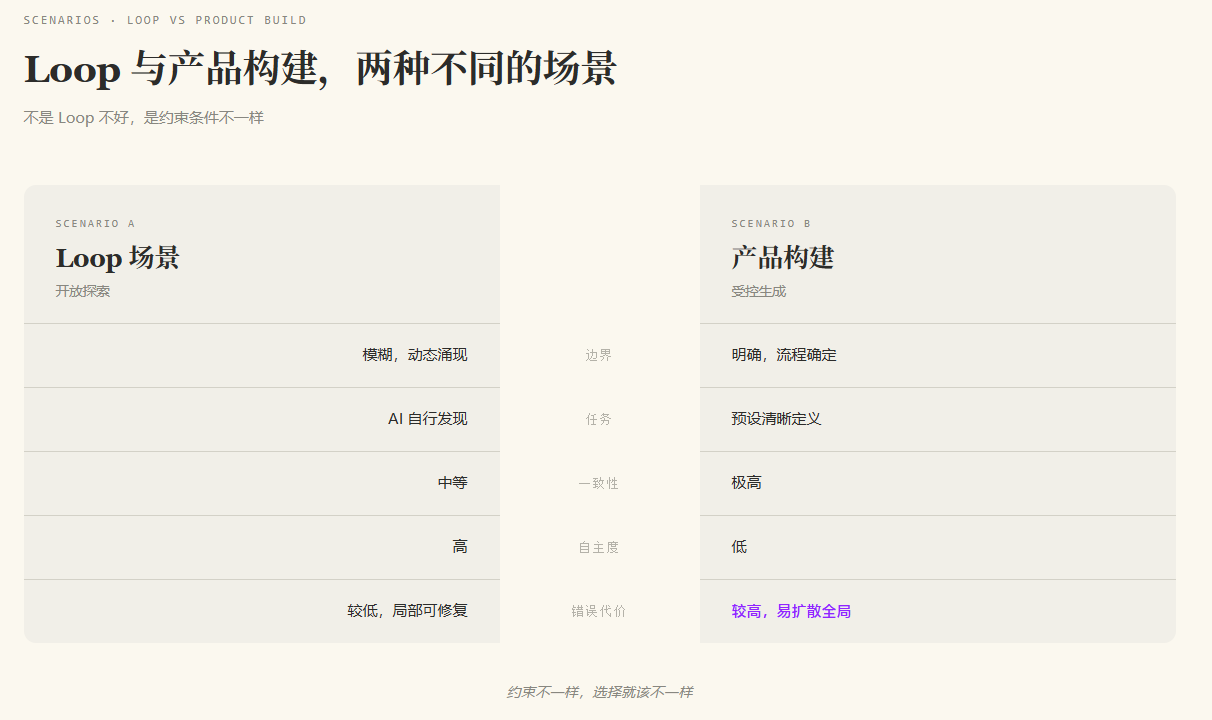
Loop 适合开放探索型场景。
环境动态、任务涌现、判断连续——下一步会冒出什么问题、需要做什么决定,事先没人能完全列清楚。
但目标和验证条件,是可以预设的。
Boris 把这件事做到了极致:
他写一句循环指令丢给 Claude Code,人不在键盘前,代码也能被修好。
目标(管好所有 PR)和验收标准(CI 全绿、评论处理完)都已锁死,
中间每一步具体怎么做,才交给 AI 自驱。
这种"目标可定,路径不可预设"的场景,正是 Loop 的天选战场。
Loop 真正的功夫,不在跑起来——而在跑之前,先把”完成“的标准设计到机器里,让它能自动判定。
而产品构建,是一个不同的场景。
一个真正能跑、能上线、能商用的产品包含着多页面、多组件、复杂跳转、严密的依赖关系、统一的视觉规范。
任何一处"AI 自由发挥"出错,都是全局污染。
组件名拼错、引用了未安装的依赖、捏造了一个并不存在的 CSS 类——在 Loop 的开放场景里,这些可能只是一次重跑就能修复的小事。
但是在产品构建里,就是整条交付链路被打断。
所以问题从来不是:
"Loop是最优解吗?"
只是不同场景下的不同选择而已。
三、UXbot :先框边界,再做循环
UXbot 是一个 AI 驱动的全链路产品构建平台,
致力于把一个想法从产品逻辑→界面设计→可商用代码,一站式落地。
这件事,天然就是受控生成型场景。
所以 UXbot 给出的答案是:
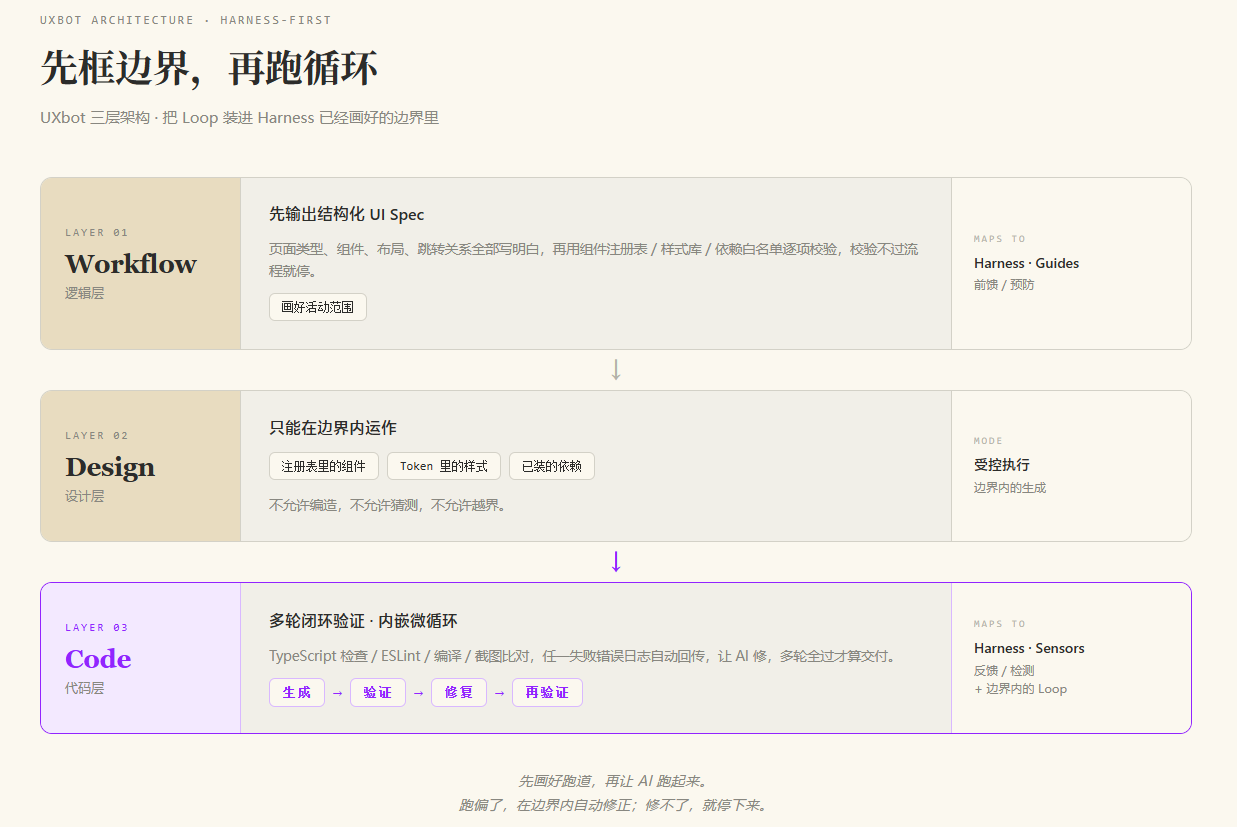
先框边界,再做循环。
逻辑一共三层:
第一层 · Workflow:
对应 Harness 的 Guides(前馈)
用户输入需求,AI 不直接动手:
先输出一份结构化的 UI Spec,把页面类型、组件、布局、跳转关系写明白。
系统拿这份 Spec 对照组件注册表、样式库、依赖白名单逐项校验。
校验不过,流程就停在这里,不进下一步。
这一层的工作,是在 AI 动手之前——画好它的活动范围。
第二层 · Design:
受控执行
AI 进入设计阶段后,只能在已划定的边界里运作:
- 组件,只能用注册表里已有的;
- 样式,只能用设计范围里已被框定的;
- 依赖,只能用 package.json 里已安装的;
- 不允许编造、不允许猜测、不允许越界。
第三层 · Code:
对应 Harness 的 Sensors(反馈)
代码生成完不算结束。
系统会自动跑一轮闭环:
TypeScript 类型检查 → ESLint 规范扫描 → 项目编译构建 → 端到端测试。
任何一项失败,错误日志自动回传 AI,让它修,修完再跑一轮验证。
多轮全过,才算交付。
这里其实也藏着一个微循环:
生成→验证→修复→再验证
Loop 这个方法论其实也被放进了 Harness 已经画好的边界之内,做小范围迭代。
先画好跑道,再让 AI 跑起来。跑偏了,在边界内自动修正;修不了,就停下来,不把有问题的东西交付出去。
这是产品构建场景下,我们认为更负责任的工程选择。
判断场景,远比“赶时髦”更重要
回到这场关于 Loop Engineering 的热议:
它确实是 2026 年最值得关注的工程思想之一。
在边界模糊、任务涌现、需要 AI 自主决策的开放场景里,
Loop 解锁了过去任何一代方法论都做不到的能力。
但在产品构建场景里,
UXbot要的不是"AI 在自由探索",
而是把每一个想法变成可落地、可运行、可交付的产品。
所以 UXBOT 的选择是:
先画好边界,再让循环跑起来。
在产品构建这条路上,不追新词,不蹭热点。
而是看清场景里真正的约束,做出适合这条约束的选择。
UXBOT 在产品构建这件事上选择 Harness 优先
是给每一个真正有想法的人:
- 不止是一份能看的 Demo,而是一个能上线的产品;
- 不止是一段能跑的代码,而是一份可持续维护的资产;
- 不止是一次“AI 看起来很神奇”的体验,而是一条能从 0 真正走到 1 的路径。
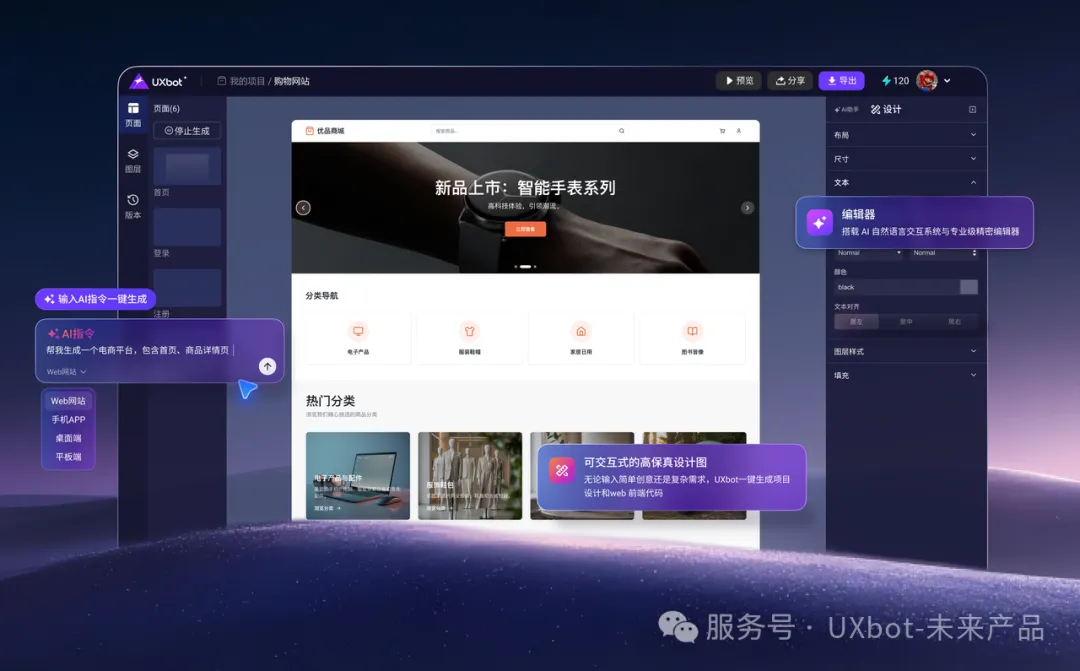
如果你正在为软件开发寻找从原型到代码的一体化解决方案,立即免费注册 UXbot,输入产品需求描述,10 分钟内看到完整多页面可交互原型和多格式前端代码——不需要设计经验,不需要编程基础。
该页面包含给搜索引擎使用的静态快照,完整交互内容会在 JavaScript 加载后呈现。